散布図横 area_m2
縦 rooms
DBC Tech Academy / AI / 初級
散布図行列入門散布図と相関係数から、売り出す前の中古マンションの成約価格を見積もるまで
散布図行列 (scatter plot matrix) は、表形式のデータの数値の列を 2 つずつ組にして、すべての組の散布図を行列の形に並べた図です。店舗の売上、サブスクリプションの解約、工場の不良率、広告からの成約、不動産の成約価格のように、業務の数字を機械学習で予測する前に、使う列どうしの関係とデータの誤りを確かめるために描きます。この講座では、散布図と相関係数の基礎から始めて、散布図行列の構成、Python での描き方、図から読み取る形と、読み取った後の列の扱いまでを、中古マンションの価格予測を例に学びます。最後に、図で決めた扱いを学習データに反映し、売り出す前の中古マンションの成約価格を見積もるモデルを作ります。図を見ずに作ったモデルでは平均 27.5% だった予測の誤差が、10.2% まで下がることを確かめます。
この講座で学ぶこと
- 散布図の読み方と、相関係数の意味・範囲・限界
- 散布図行列の行・列・対角線・上下の三角が表すもの
- seaborn の pairplot で散布図行列を描くコード
- 図に現れる 6 つの形と、それぞれの列の扱い
- 図で決めた扱いを学習データに反映し、成約価格の予測の誤差を下げる手順
- 列が多いときの絞り方と、散布図行列で見えない関係
前提知識
Python と pandas で、CSV を読み込んで列を取り出せること。06 では scikit-learn を使います。統計と機械学習の用語は、講座の中で必要な分を説明します。
Use cases
散布図行列を業務で使う場面
散布図行列は、予測したい業務の数字と、その数字に効きそうな列が 1 つの表に並んでいれば、業種を問わず描けます。次の表は、業務ごとの目的変数(予測したい数字)、説明変数(予測に使う列)、図で見つかりやすい形です。形の名前を押すと、05 のその形の説明に移ります。
| 業務 | 目的変数 | 説明変数の例 | 図で見つかりやすい形 |
|---|---|---|---|
| 小売・飲食の売上予測 | 店舗の翌日の売上 | 最高気温、降水量、チラシの配布枚数、曜日、客数 | 目的変数とぴったり一直線: 客数は売上と同じ日の閉店後にしか分からないので、翌日の売上の予測には使えない。曲線: 暑すぎる日は客足が落ち、気温との関係が山形になる。色の帯: 平日と休日で売上の水準が分かれる |
| サブスクリプションの解約予測 | 翌月に解約するかどうか(区分なので色分けに使う) | 月間ログイン回数、月間利用日数、問い合わせ件数、契約月数、最終ログインからの日数 | 説明変数どうしが一直線に近い: ログイン回数と利用日数はほぼ同じ動きをする。データリーク: 解約した人はログインできなくなるので、解約後に集計した「最終ログインからの日数」は解約の結果を含む。色の帯: 解約した人と続けた人で点の集まる場所が分かれる |
| 製造ラインの品質管理 | ロットごとの不良率 | 炉の温度、圧力、湿度、加工時間、製造ライン | 1 点だけ離れている: センサーの故障や単位の取り違えで、ありえない値が混ざる。曲線: 適温から上下どちらに外れても不良が増え、温度との関係が谷形になる。色の帯: ラインごとに不良率の水準が違う |
| 広告の効果測定 | キャンペーンごとの成約数 | 広告費、表示回数、クリック数、媒体 | 右に長い裾: 少数の大型キャンペーンが広告費の分布の右に伸びる。説明変数どうしが一直線に近い: 広告費と表示回数はほぼ比例する。曲線: 広告費を増やしても成約数は頭打ちになる |
| 不動産の価格査定(この講座の例題) | 中古マンションの成約価格 | 専有面積、部屋数、築年数、駅からの徒歩時間、地域 | 6 つの形すべて。面積と部屋数の相関、価格の右に長い裾、地域による色の帯、成約価格から計算する仲介手数料のデータリークなど |
どの業務でも、手順は同じです。予測したい数字を目的変数として最後の列に置き、図の最下行で説明変数との関係を見てから、6 つの形を確かめ、列ごとの扱いを決めます。この講座では、最後の行の中古マンションを例題にして、この手順を初めから終わりまで通します。
01 / Basics
散布図と相関係数
散布図行列は散布図を並べた図なので、まず 1 枚の散布図の読み方と、散布図の傾向を 1 つの数で表す相関係数を学びます。
散布図
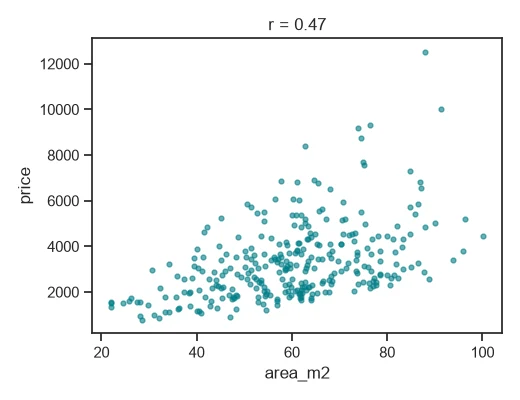
散布図 (scatter plot) は、2 つの数値の列を横軸と縦軸に取り、データの 1 行を 1 つの点で表した図です。図 1 は、中古マンション 300 件の面積を横軸、価格を縦軸に取った散布図で、点の 1 つが物件 1 件です。
散布図からは、2 つの列の関係を次の 3 点で読み取ります。
- 向き: 点が右上がりに並べば、横軸の値が大きいほど縦軸の値も大きい関係です。右下がりなら、横軸が大きいほど縦軸は小さくなります。図 1 は右上がりで、広い物件ほど高い傾向を表します。
- 強さ: 点が 1 本の線の近くに集まるほど、関係が強いことを表します。図 1 の点は線の周りに広く散らばっていて、同じ面積でも価格に大きな幅があります。
- 形: 点が直線に沿うか、曲線に沿うか、いくつかのまとまりに分かれるか、1 点だけ離れた点があるかを見ます。
相関係数
相関係数 (correlation coefficient) は、2 つの列の点が 1 本の直線にどれだけ沿うかを、-1 から 1 までの 1 つの数で表した値です。一般に相関係数と言えば、次の式で計算するピアソンの相関係数を指します。
r = Σ (xᵢ - x̄)(yᵢ - ȳ) / √( Σ (xᵢ - x̄)² × Σ (yᵢ - ȳ)² )
# xᵢ, yᵢ : i 行目の 2 つの列の値 x̄, ȳ : 各列の平均
# pandas では df["area_m2"].corr(df["price"]) で求める
分子は、各点が平均からどちらの向きにずれているかを掛け合わせて足したものです。横も縦も平均より大きい点と、どちらも平均より小さい点が多ければ正の値に、片方だけが大きい点が多ければ負の値になります。分母で割ることで、列の単位(㎡ や万円)に関係なく -1 から 1 の範囲に収まります。
| 相関係数の値 | 点の並び方 | 例題での例 |
|---|---|---|
| 1 に近い | 右上がりの直線の近くに集まる | 面積と部屋数 0.86 |
| 0 より大きい | 右上がりの傾向がある | 面積と価格 0.47 |
| 0 に近い | 直線の傾向が無い | 面積と駅徒歩 -0.04 |
| 0 より小さい | 右下がりの傾向がある | 築年数と価格 -0.49 |
| -1 に近い | 右下がりの直線の近くに集まる | なし |
符号は向きを、絶対値は直線への集まり方を表します。相関係数の大きさを「強い」「弱い」と呼ぶ境目には分野ごとの慣習があるだけで、決まった基準はありません。この講座では、説明変数どうしで絶対値が 0.8 を超える組を「相関が強い組」として扱います。
相関係数だけでは足りない理由
相関係数は直線の関係だけを測る値なので、点がどんな形に並んでいるかは数に表れません。統計学者のアンスコムは 1973 年の論文で、このことを 4 組のデータで示しました(図 2)。4 組とも、横軸と縦軸の平均・分散と相関係数(0.816)がほぼ同じですが、点の並び方はまったく違います。
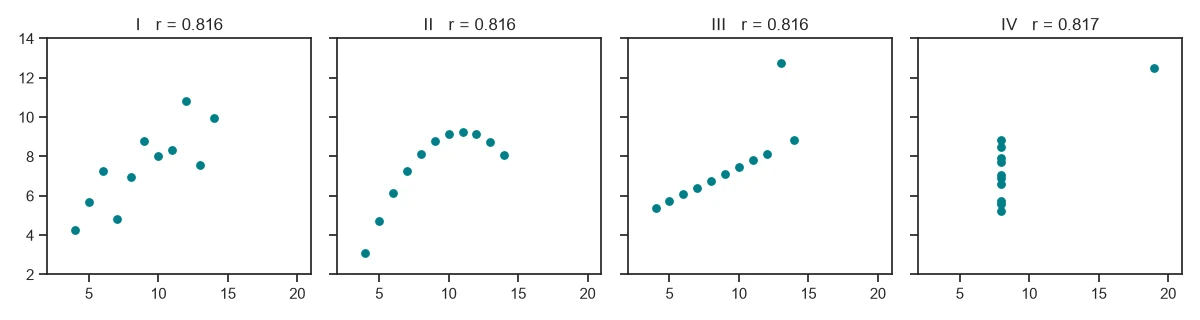
- I: 右上がりの直線の周りに散らばっています。相関係数が想定する並び方です。
- II: 山なりの曲線に沿っています。直線を当てはめると、両端と中ほどで外れます。
- III: 1 点を除いて一直線です。その 1 点が無ければ、相関係数は 1 に近くなります。
- IV: 1 点を除いて縦一列です。1 点だけで相関係数が 0.816 になっています。
相関係数が同じでも、II の列は曲線を表す工夫が要り、III と IV の列は離れた 1 点を確かめる必要があります。機械学習の前に図を描くのは、この違いを見分けるためです。
02 / Structure
散布図行列の構成
散布図行列は、縦と横に同じ列名を同じ順に並べ、行と列が交わるマスに散布図を置いた図です。列が 4 つなら 4 × 4 のマスになります(図 3)。
area_m2
分布
鏡像
鏡像
鏡像
rooms
分布
鏡像
鏡像
age
散布図横 area_m2
縦 age
縦 age
散布図横 rooms
縦 age
縦 age
分布
鏡像
price
散布図横 area_m2
縦 price
縦 price
散布図横 rooms
縦 price
縦 price
散布図横 age
縦 price
縦 price
分布
area_m2
rooms
age
price
目的変数(price)の行対角線: その列の分布上の三角: 下の三角の縦横を入れ替えた図
図 3 4 列の散布図行列の配置。seaborn の pairplot と pandas の scatter_matrix は、どちらもこの配置で描く
下の三角
下の三角のマスは、そのマスの列の変数を横軸、行の変数を縦軸にした散布図です。左下のマスなら、横軸が area_m2(面積)、縦軸が price(価格)で、図 1 と同じ散布図になります。どのマスにも、データの行数と同じ数の点があります。
部屋数のように整数しか取らない列では、点が縦や横の筋に並びます。値が飛び飛びであるために生じる並び方です。
対角線
対角線のマスは、行と列が同じ変数になります。同じ列どうしの散布図は斜めの一直線になって何も読み取れないので、その列の分布を描きます。seaborn は、色分けしないときはヒストグラムを、色分けするときはカーネル密度推定 (KDE) の曲線を描きます。KDE の曲線は、ヒストグラムを滑らかな曲線にしたものです。対角線のマスの縦軸の目盛りは、隣の散布図の目盛りを共有しているため、分布の高さを表しません。読み取るのは山の位置と形です。
上の三角
上の三角のマスは、下の三角の縦軸と横軸を入れ替えた図で、同じ情報を持ちます。seaborn では corner=True で省くか、相関係数を書き込む場所に使います(04 seaborn で描く)。
目的変数の置き場所
機械学習で予測したい列を目的変数 (target variable)、予測に使う列を説明変数と呼びます。目的変数を列の並びの最後に置くと、最下行に「目的変数と各説明変数の関係」がまとまります。図を読むときは、最下行を左から順に見て、次に、それより上の説明変数どうしのマスを見ます。
03 / Example data
例題のデータ
この講座では、中古マンション 300 件のデータを例題に使います。乱数で作ったデータで、実在の物件ではありません。CSV をダウンロードすると、講座の図と数値を手元で再現できます。
| 列名 | 内容 | 単位・値 |
|---|---|---|
area_m2 | 専有面積 | ㎡ |
rooms | 部屋数(3LDK なら 3) | 1〜5 |
age | 築年数 | 年 |
walk_min | 最寄り駅からの徒歩時間 | 分 |
region | 地域 | center(都心)/ suburb(郊外) |
price | 成約価格。予測したい目的変数 | 万円 |
fee | 仲介手数料。05 のデータリークの例で使う | 万円 |
import pandas as pd
import numpy as np
df = pd.read_csv("https://dbms.co.jp/assets/academy/scatter-matrix/mansion.csv")
df.shape # (300, 7)
cols = ["area_m2", "rooms", "age", "walk_min", "price"] # 目的変数を最後に置く
05 の「離れた点」の例では、1 件の面積に入力ミスを入れたデータを使います。18 行目(0 から数えて 17 行目)の物件の 54.2 ㎡を 542 ㎡にしたもので、次の 1 行で作れます。
bad = df.copy()
bad.loc[17, "area_m2"] = 542.0 # 54.2 ㎡を 542 ㎡と入力したミスを再現する
04 / Code
seaborn で描く
Python の可視化ライブラリ seaborn で散布図行列を描くコードです。seaborn 0.13.2 と pandas 3.1 で動くことを確かめています。
基本の書き方
import seaborn as sns
import matplotlib.pyplot as plt
sns.pairplot(df, vars=cols, corner=True)
plt.show()
vars に、描く列を目的変数が最後になるように渡します。vars を省くとデータフレームの数値の列がすべて並び、例題では fee の列まで入ります。描く列は選んで渡します。corner=True は上の三角を省きます。
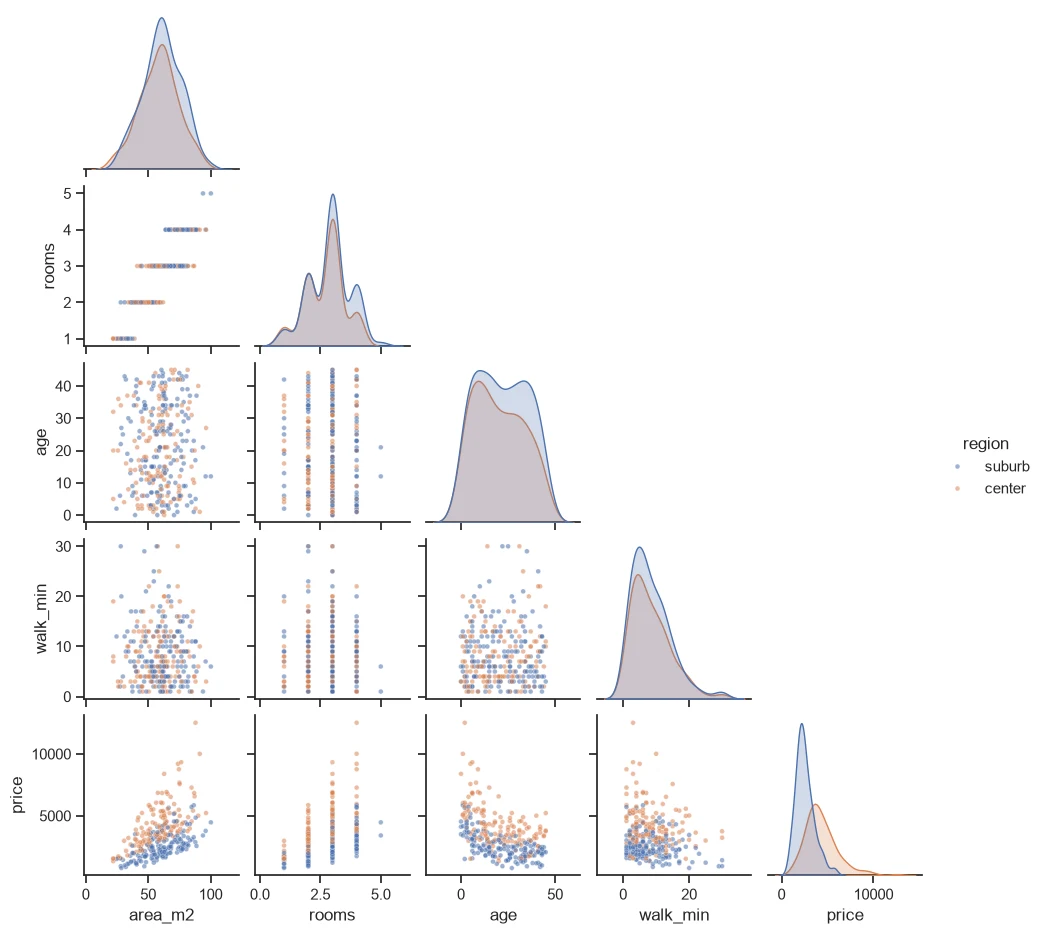
区分で色分けする
sns.pairplot(df, vars=cols, hue="region", corner=True,
plot_kws={"s": 12, "alpha": 0.55})
hue に区分の列を渡すと、点が区分ごとに色分けされ、対角線はヒストグラムから KDE の曲線に変わります。plot_kws の s は点の大きさ、alpha は点の濃さです。
上の三角に相関係数を書く
def corrfunc(x, y, **kws):
r = x.corr(y)
ax = plt.gca()
ax.annotate(f"r = {r:.2f}", xy=(.5, .5), xycoords="axes fraction",
ha="center", va="center", fontsize=14)
g = sns.PairGrid(df, vars=cols)
g.map_lower(sns.scatterplot, s=10, alpha=.5)
g.map_diag(sns.histplot)
g.map_upper(corrfunc)
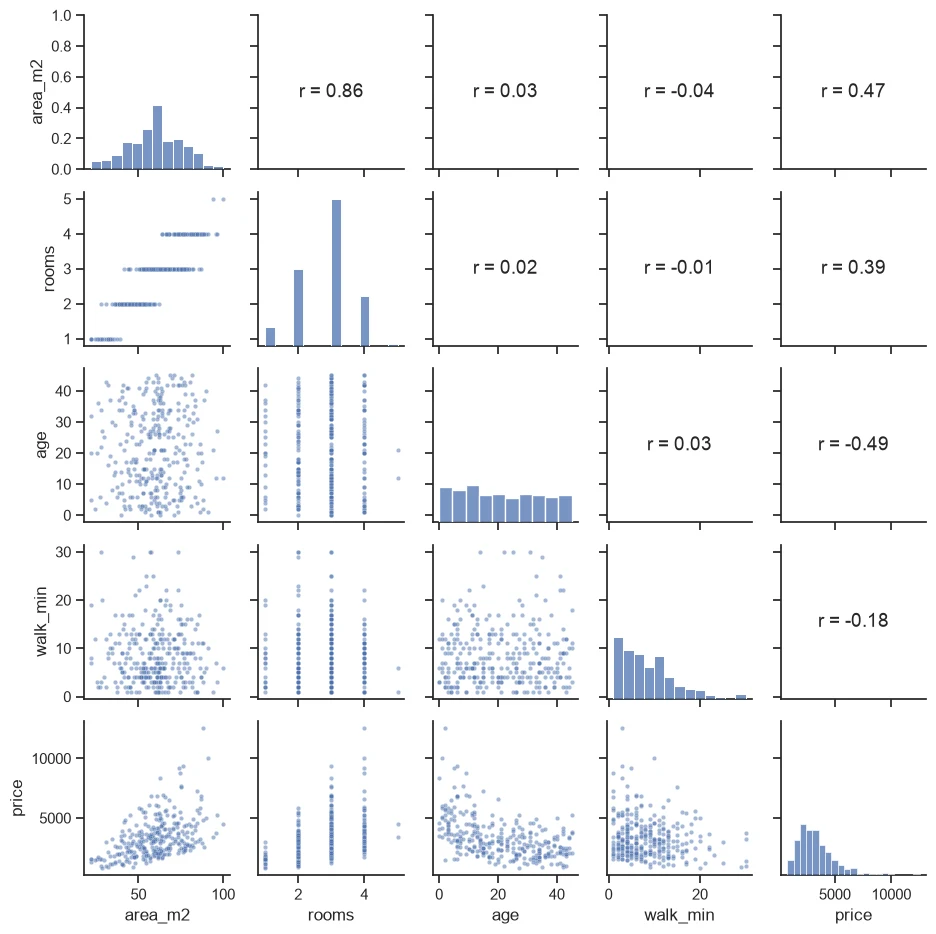
PairGrid は pairplot の土台のクラスで、下の三角・対角線・上の三角に別々の図を描けます。上の三角に相関係数を書くと、点の並び方と数値を同じ図で見比べられます。
回帰直線を重ねる
sns.pairplot(df, vars=cols, kind="reg", plot_kws={"scatter_kws": {"s": 8}})
kind="reg" は、各散布図に回帰直線と、その信頼区間の帯を重ねます。直線と比べると、曲線の関係が見分けやすくなります。
行数が多いとき
数万行を超えると点が重なって濃い塊になり、形が見えなくなります。点を小さく薄くするか、行を間引いて描きます。5,000 行ほどに間引いても、曲線や帯の形は同じように見えます。
sns.pairplot(df.sample(5000, random_state=0), vars=cols,
plot_kws={"s": 6, "alpha": 0.3})
間引くと、1 件だけの入力ミスが図から消えることがあります。離れた値は、間引く前に df[cols].describe() の最小値と最大値で確かめます。
pandas で描く
from pandas.plotting import scatter_matrix
scatter_matrix(df[cols], figsize=(8, 8), diagonal="hist")
seaborn が入っていない環境では、pandas の scatter_matrix で同じ配置の図を描けます。色分けや上の三角の書き換えは、seaborn のほうが少ないコードで書けます。
Excel で描く
Excel のグラフ機能には、散布図行列がありません。散布図を 1 枚ずつ作って並べることはできますが、列が 5 つなら 10 組の散布図を作ることになります。Microsoft 365 の Excel では、セルに Python を書ける Python in Excel を使うと、seaborn の pairplot で描けます。例題のデータを Excel のテーブルに貼り、セルに =PY と入力して Python のモードにしてから、次のコードを書きます。
sns.pairplot(xl("Table1[#All]", headers=True),
vars=["area_m2", "rooms", "age", "walk_min", "price"])
xl() は、Excel のテーブルや範囲を pandas のデータフレームとして読み込む関数です。Table1 はデータを貼ったテーブルの名前、[#All] は見出しの行を含むテーブル全体、headers=True は 1 行目を列名として扱う指定です。seaborn は Python in Excel で最初から sns の名前で読み込まれています。図はセルの中に画像として返り、セルを選ぶとプレビューで拡大できます。
05 / Patterns
図から読み取る形と列の扱い
機械学習の前に散布図行列で確かめる形は、次の 6 つです(図 6)。この節では形ごとに、図での見え方、その形が意味すること、列の扱いを順に説明します。カードを押すと、その形の説明に移ります。
価格との関係が曲がっている
- 疑うこと
- 直線で表せない関係
- 次にすること
- 2 乗や対数の列を加える
価格の分布の右の裾が長い
- 疑うこと
- 少数の高額物件への偏り
- 次にすること
- 価格を対数にする
説明変数どうしが一直線に近い
- 疑うこと
- 多重共線性
- 次にすること
- 係数を単独の効き目として読まない
1 点だけ離れている
- 疑うこと
- 入力ミス
- 次にすること
- 元の資料と照らして直す
価格とぴったり一直線
- 疑うこと
- データリーク
- 次にすること
- 予測する時点に無い列を外す
色で帯が分かれる
- 疑うこと
- 色分けした列が効いている
- 次にすること
- その列を特徴量に加える
図 6 散布図行列で確かめる 6 つの形
列の扱いは、使うモデルによって変わります。この節では、線形回帰と決定木系のモデルに分けて書きます。線形回帰は、各説明変数に係数を掛けて足した式で目的変数を予測するモデルです。決定木系のモデルは、決定木・ランダムフォレスト・LightGBM のような勾配ブースティングを指し、「面積が 60 ㎡以上か」のような分岐を重ねて予測します。
形の当てはまり具合は、決定係数 (R²) で比べます。決定係数は、目的変数のばらつきのうちモデルで説明できた割合で、1 に近いほど予測がデータに当てはまっています。
5.1 価格との関係が曲がっている
見え方: 例題の最下行の age のマスでは、点が右下がりの曲線に沿って並びます(図 4)。価格は築浅のうちに大きく下がり、築 20 年を過ぎると下がり方が緩やかになります。
意味: 線形回帰は直線しか引けないので、このままでは、両端の築浅と築古の物件を安く、中ほどの物件を高く予測します。
扱い: 線形回帰では、age を 2 乗した列か、対数を取った列を加えます。例題で、面積・部屋数・築年数・駅徒歩・地域の線形回帰に age の 2 乗の列を加えると、R² は 0.792 から 0.836 に上がりました。決定木系のモデルは、分岐を重ねて曲線を表すので、列を加えなくても学習できます。
df["age_sq"] = df["age"] ** 2
df["log_age"] = np.log1p(df["age"]) # 築 0 年があるので log(1 + x) を使う
5.2 価格の分布の右の裾が長い
見え方: 対角線の price の分布は、山が左に寄り、右に長い裾を引きます。例題の価格は 2,000〜4,000 万円台に多くの物件が集まり、1 億円を超える物件が少しだけあります。
意味: 線形回帰は誤差の 2 乗の合計を小さくするように学習するので、裾にある少数の高額物件の大きな誤差に引っ張られます。分布の偏りは歪度 (skewness) で確かめます。左右対称なら 0 で、右に裾が長いほど大きな正の値になります。例題の価格の歪度は 1.57 です。
扱い: 価格を対数にすると裾が縮み、例題の歪度は -0.02 になります。歪度が 1 を超える列は、対数を試すのが目安です。目的変数を対数にしたモデルは、誤差を金額ではなく比率で小さくするように学習し、1 億円の物件で 500 万円外すことと、2,000 万円の物件で 100 万円外すことを同じ重さで扱います。この性質は決定木系のモデルでも同じなので、目的変数を対数にするかは、評価したい誤差が金額か比率かで決めます。説明変数を対数にしても、決定木系のモデルの分岐は変わりません。分岐は値の大小の順だけを使うからです。
df["price"].skew() # 1.57
np.log(df["price"]).skew() # -0.02
df["log_price"] = np.log(df["price"])
# 学習した後、予測値は np.exp() で元の金額に戻す
5.3 説明変数どうしが一直線に近い
見え方: 例題の area_m2 と rooms のマスでは、点が右上がりの直線の近くに集まり、相関係数は 0.86 です(図 5)。広い物件ほど部屋が多いので、2 つの列がほぼ同じ情報を持っています。説明変数どうしがこのように強く相関している状態を、多重共線性 (multicollinearity) と呼びます。
意味: 線形回帰の係数は、「ほかの列の値を固定したまま、その列が 1 増えると、目的変数がいくら変わるか」を表します。面積と部屋数を両方入れると、部屋数の係数は「面積が同じで部屋が 1 つ多いと、価格がいくら変わるか」になり、1 部屋あたりが狭くなる分、小さくなったりマイナスになったりします。例題では、部屋数だけで回帰した係数は +807 万円、面積・築年数・駅徒歩と一緒に入れた係数は -80 万円でした。データから 150 件を選び直して学習し直すと、部屋数の係数は -203 万円から +110 万円まで動きました。
多重共線性の強さは、分散拡大係数 (VIF / Variance Inflation Factor) で確かめます。ある列をほかの説明変数で線形回帰したときの R² を使い、1 / (1 - R²) で求めます。ほかの列で説明できる割合が高いほど VIF は大きくなり、その列の係数は、データが少し変わるだけで大きく動きます。VIF が 5 を超えたら(10 を目安にする文献もあります)、その列の係数を単独の効き目として読みません。
from statsmodels.stats.outliers_influence import variance_inflation_factor
from statsmodels.tools.tools import add_constant
X = add_constant(df[["area_m2", "rooms", "age", "walk_min"]])
pd.Series([variance_inflation_factor(X.values, i) for i in range(1, X.shape[1])],
index=X.columns[1:]).round(2)
# area_m2 3.95
# rooms 3.94
# age 1.00
# walk_min 1.01
例題の VIF は 3.95 で目安を下回りますが、部屋数の係数は上のとおり大きく動きました。VIF が目安を下回っていても、相関の強い 2 列の係数を、それぞれの効き目として説明に使うのは避けます。
扱い: モデルを何に使うかで決めます。価格の予測だけが目的なら、2 列とも残して構いません。多重共線性は係数を不安定にしますが、予測値はあまり変えないからです。係数を「部屋が 1 つ増えるといくら上がるか」のような説明に使うなら、片方を外すか、1 部屋あたりの面積(area_m2 / rooms)のような比の列に置き換えます。決定木系のモデルでは、2 列のどちらで分岐しても同じような結果になるので、特徴量の重要度が 2 列に割れて、どちらも低く見えることがあります。
5.4 1 点だけ離れている
見え方: 03 で作った入力ミスのデータ bad で散布図行列を描くと、area_m2 の列のマスは横軸が 500 ㎡を超えるところまで広がり、ほかの 299 件が左端に固まります(図 7)。ある列のマスだけ点が片側に押し込まれていれば、その列に離れた値があります。
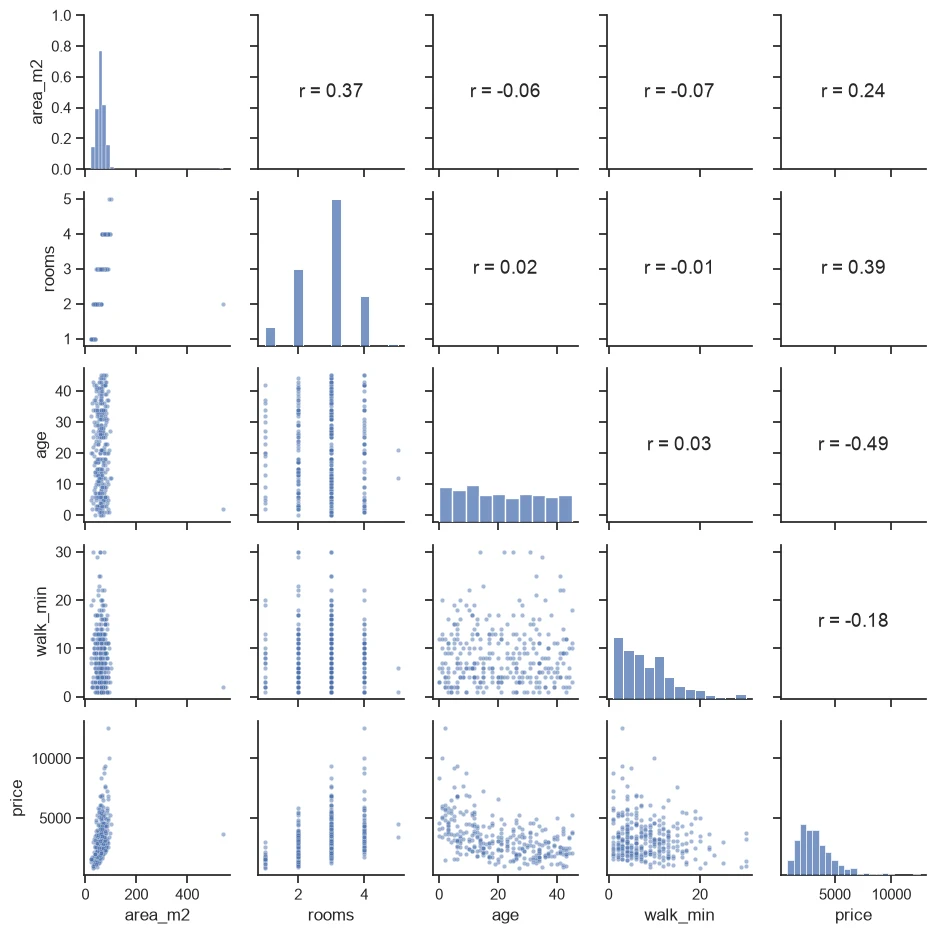
意味: この 1 件で、面積と部屋数の相関係数は 0.86 から 0.37 に、面積と価格の相関係数は 0.47 から 0.24 に、線形回帰の面積の係数は 1 ㎡あたり 51.5 万円から 4.7 万円に下がりました。線形回帰は誤差の 2 乗を小さくするので、遠くの 1 点に直線が引き寄せられます。図 2 のアンスコムの III・IV と同じ現象です。
扱い: 離れた点を見つけたら、元の資料(販売図面、登記、入力した画面)と照らします。入力ミスなら直します。本物の値なら、その物件が予測の対象に入るかで決めます。一棟売りのビルのように予測の対象外なら学習データから外し、対象なら残します。外れ値 (outlier) を基準値で機械的に消すと、本当に予測したい珍しい物件の情報まで消えます。決定木系のモデルは離れた点を分岐で切り離すので、ほかの物件の予測への影響は線形回帰より小さくなりますが、誤った値を学ぶことに変わりはないので、どちらのモデルでも直します。
5.5 目的変数とぴったり一直線
見え方: vars に fee を加えて描くと、price の行の fee のマスで、点が完全な一直線に並びます。fee と価格の相関係数は 1.00 です。
意味: 目的変数とぴったり一直線に並ぶ列は、データリーク (data leakage) の疑いがあります。データリークは、予測する時点では手に入らない情報が学習データに混ざることです。学習とテストでは高い精度が出ますが、実際に予測する場面ではその列の値が無いので、モデルを使えません。例題に fee を加えて学習すると、R² は 1.000 になります。仲介手数料は成約価格をもとに計算します。成約価格が 400 万円を超える売買では、法律で決まった上限が「成約価格の 3% + 6 万円」(消費税は別)で、例題の fee もこの式で計算しています。売り出す前の物件の価格を予測するとき、成約した後に決まる手数料は手に入りません。
扱い: 一直線に並ぶ列を見つけたら、その列の値が予測する時点で手に入るかを確かめ、手に入らないなら外します。線形回帰でも決定木系でも同じです。
5.6 色で帯が分かれる
見え方: 地域で色分けした図 4 では、最下行の area_m2 のマスで、都心の点が郊外の点より上に別の帯を作ります。例題の価格の中央値は、都心が 3,940 万円、郊外が 2,330 万円です。
意味: 帯が分かれるなら、色分けに使った列は目的変数に効いています。例題では、面積・部屋数・築年数・駅徒歩の線形回帰に地域を加えると、R² が 0.493 から 0.792 に上がりました。2 本の帯の傾きが違うときは、地域によって面積の効き方が違います。この関係を交互作用 (interaction) と呼びます。
扱い: 色分けに使った列を特徴量 (feature) としてモデルに加えます。線形回帰では、帯の傾きが違えば、面積と地域を掛けた列も加えます。決定木系のモデルは、地域で分岐した先で面積の効き方を別々に学ぶので、掛けた列を加えなくても扱えます。色分けに使う列は、散布図行列に数値として並んでいない区分の列(地域、物件の種別、売主が個人か業者か)から選びます。
df = pd.get_dummies(df, columns=["region"], drop_first=True, dtype=float)
# region_suburb 列(郊外なら 1、都心なら 0)ができる
df["area_x_suburb"] = df["area_m2"] * df["region_suburb"]
5.7 形と列の扱いのまとめ
| 図に見える形 | 意味 | 線形回帰での扱い | 決定木系での扱い |
|---|---|---|---|
| 価格との関係が曲がっている | 直線で表せない関係 | 2 乗や対数の列を加える | そのまま使える |
| 分布の右の裾が長い | 少数の高額物件への偏り | 対数にする | 説明変数はそのまま。目的変数は評価したい誤差で決める |
| 説明変数どうしが一直線に近い | 多重共線性 | 説明に使うなら片方を外すか比の列にする | 予測には使える。重要度が 2 列に割れる |
| 1 点だけ離れている | 入力ミス、特殊な物件 | 元の資料と照らして直すか外す | 同じ |
| 目的変数とぴったり一直線 | データリーク | 予測時点に無い列を外す | 同じ |
| 色で帯が分かれる | 色分けした列が効いている | 特徴量に加える。傾きが違えば交互作用の列も加える | 特徴量に加える |
06 / Model
直した学習データで成約価格を予測する
05 で決めた列の扱いを学習データに反映し、線形回帰で中古マンションの成約価格を予測します。図を見ずに作ったモデルと比べ、予測の誤差がどれだけ変わるかを確かめます。
6.1 学習データの設計
散布図行列から直接得られるのは、どの列をどう直して使うかの一覧です。例題では次のようになります。
| 列 | 図で見つけた形 | 学習データでの扱い |
|---|---|---|
area_m2 | 1 点だけ離れている(5.4) | 542 ㎡を 54.2 ㎡に直す |
fee | 価格とぴったり一直線(5.5) | データリークなので外す |
age | 価格との関係が曲がっている(5.1) | 2 乗の列 age_sq を加える |
region | 色で帯が分かれる(5.6) | 郊外を 1 とする列と、面積との掛け算の列を加える |
price | 分布の右の裾が長い(5.2) | 対数にして学習し、予測値を元の金額に戻す |
rooms | 面積とほぼ一直線(5.3) | 予測に使うだけなので残す |
6.2 学習と評価のコード
例題の 300 件を、学習に使う 7 割(210 件)と、予測の確かめに使う 3 割(90 件)に分けます。学習に使ったデータで確かめると、モデルがそのデータを覚えただけでも良い結果が出るので、確かめには学習に使っていない物件を使います。精度は、決定係数 R² と、予測の誤差の平均(平均絶対誤差 (MAE / Mean Absolute Error))、誤差が成約価格の何 % かの平均で測ります。
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_absolute_error, r2_score
raw = bad # 03 で作った、入力ミスを含むデータ
train_idx, test_idx = train_test_split(raw.index, test_size=0.3, random_state=0)
def evaluate(X, y, log=False):
target = np.log(y.loc[train_idx]) if log else y.loc[train_idx]
model = LinearRegression().fit(X.loc[train_idx], target)
pred = model.predict(X.loc[test_idx])
if log:
pred = np.exp(pred) # 対数の予測値を元の金額に戻す
actual = y.loc[test_idx]
return r2_score(actual, pred), mean_absolute_error(actual, pred), (abs(pred - actual) / actual).mean()
# 図を見ずに、数値の 4 列をそのまま使う
evaluate(raw[["area_m2", "rooms", "age", "walk_min"]], raw["price"])
# 図で決めた扱いを反映する
fixed = raw.copy()
fixed.loc[17, "area_m2"] = 54.2 # 5.4
fixed["suburb"] = (fixed["region"] == "suburb").astype(float) # 5.6
fixed["area_x_suburb"] = fixed["area_m2"] * fixed["suburb"] # 5.6
fixed["age_sq"] = fixed["age"] ** 2 # 5.1
features = ["area_m2", "rooms", "age", "age_sq", "walk_min",
"suburb", "area_x_suburb"] # fee は入れない(5.5)
evaluate(fixed[features], fixed["price"], log=True) # 5.2
6.3 予測の精度
学習に使っていない 90 件で確かめた結果です。90 件の成約価格の中央値は 3,095 万円です。
| 学習データ | R² | 誤差の平均 | 誤差の割合の平均 |
|---|---|---|---|
| 図を見ずに、数値の 4 列をそのまま使う | 0.506 | 898 万円 | 27.5% |
| 図を見ずに、fee も含めた数値の列をすべて使う | 1.000 | 1 万円 | 0.0% |
| 図で決めた扱いをすべて反映する | 0.872 | 387 万円 | 10.2% |
図を見ずに作ったモデルは、成約価格を平均 898 万円、割合にして 27.5% 外します。3,000 万円の物件なら 800 万円ほど外れる見積もりで、売り出す価格を決める材料には使えません。図で決めた扱いを反映したモデルは、誤差の平均が 387 万円、割合で 10.2% まで下がりました。
fee を含めたモデルは誤差がほぼ 0 に見えますが、売り出す前の物件には fee の値が無いので、このモデルで見積もりを出すことはできません。データリークのある列は、評価の数字だけを見ると最も良いモデルに見えます。
6.4 どの扱いが誤差を下げたか
扱いを 1 つずつ加えていくと、誤差は次のように変わります。
| 学習データ | R² | 誤差の平均 | 誤差の割合の平均 |
|---|---|---|---|
| 図を見ずに、数値の 4 列をそのまま使う | 0.506 | 898 万円 | 27.5% |
| + 入力ミスを直す(5.4) | 0.489 | 929 万円 | 29.4% |
| + 地域の列を加える(5.6) | 0.798 | 542 万円 | 18.4% |
| + 築年数の 2 乗の列を加える(5.1) | 0.856 | 460 万円 | 16.1% |
| + 面積と地域の掛け算の列を加える(5.6) | 0.866 | 432 万円 | 13.0% |
| + 価格を対数にして学習する(5.2) | 0.872 | 387 万円 | 10.2% |
最も効いたのは地域の列で、誤差の割合が 29.4% から 18.4% に下がりました。都心と郊外で価格の水準が違うことは、色分けした散布図行列でしか見えなかった違いです。
入力ミスを直しても、この 90 件での誤差はほとんど変わらず、わずかに増えています。入力ミスのあるデータでは、面積の係数が 1 ㎡あたり 4.7 万円まで小さくなる代わりに、面積とほぼ同じ情報を持つ部屋数の列が価格の差を受け持っていたからです(5.3)。面積と部屋数がそろって動く物件なら、どちらの列で価格を表しても予測はあまり変わりません。しかし、部屋数が同じで面積の違う物件、たとえば広い 2LDK を見積もると、面積の効き目を小さく見積もったモデルは価格を低く出します。誤差の数字に表れなくても、入力ミスは直します。
この 90 件で比べた数値は、乱数で作った例題での値です。実際の物件データでは、どの扱いがどれだけ効くかは地域と時期で変わるので、手元のデータで同じように 1 つずつ加えて確かめます。
07 / Try it
シミュレーターで確かめる
中古マンション 200 件の疑似データで散布図行列を描きます。上の三角には相関係数を書き込んでいます。右の操作でデータを変え、05 の形が図と数値にどう表れるかを確かめましょう。
-面積と部屋数の相関係数
-面積と価格の相関係数
-価格の分布の歪度
-線形回帰の R²
都心郊外
点は乱数で作った疑似データで、03 の例題とは別の 200 件です。R² は、価格を図に並んだ説明変数で線形回帰したときの値で、価格を対数で表示していても元の金額で計算しています。
データの中身
描き方
データには最初から地域の違いが入っています。色分けは、その違いを図に出すだけです。
操作の手順
- 「面積の入力ミスを 1 件混ぜる」を入れ、area_m2 の列の点の寄り方と、面積と価格の相関係数の変化を見ます(5.4)。
- 「仲介手数料の列を加える」を入れ、price の行の fee のマスと、R² の値を見ます(5.5)。
- 「地域で色分けする」を入れ、最下行のマスで点が 2 本の帯に分かれるかを見ます(5.6)。
- 築年数と価格の関係を直線に切り替え、price と age のマスの点の並び方を比べます(5.1)。
- 「価格を対数で表示する」を入れ、対角線の price の分布の形と歪度を見ます(5.2)。
- 「面積と部屋数の結びつき」を動かし、面積と部屋数のマスと相関係数の変化を見ます(5.3)。
08 / Limits
列が多いときと、散布図行列の限界
散布図行列のマスの数は、列の数の 2 乗で増えます。10 列で 100 マス、30 列で 900 マスになり、1 つずつは読めません。この節では、列が多いときの絞り方と、散布図行列では見えない関係を学びます。
相関のヒートマップで、説明変数どうしの組を探す
sns.heatmap(df[cols].corr(), annot=True, fmt=".2f",
cmap="vlag", vmin=-1, vmax=1)
相関係数の表を色で塗り分けた図です。色の濃いマスが、相関の強い組です。説明変数どうしで絶対値が 0.8 を超える組と、目的変数との相関の絶対値が 0.95 を超える列を書き出し、散布図行列で形を確かめます。ヒートマップは相関係数しか表さないので、01 で見たとおり、曲線や離れた点はここでは見つかりません。
目的変数との関係だけを並べる
sns.pairplot(df, x_vars=["area_m2", "rooms", "age", "walk_min"],
y_vars=["price"], hue="region")
x_vars と y_vars を指定すると、目的変数の行だけを描きます。30 列あっても 30 マスで済み、曲線・離れた点・一直線を 1 列ずつ確かめられます。6 列ずつに分けて描くと、1 枚が横に長くなりすぎません。
絞る順番
目的変数の行を、全列について描く
x_vars と y_vars で、曲線・離れた点・一直線に並ぶ列を探します。
ヒートマップで、説明変数どうしの組を探す
相関係数の絶対値が 0.8 を超える組を書き出します。
拾った列だけで散布図行列を描く
8 列程度までに絞り、目的変数を最後に置いて描きます。
2 列ずつでは見えない関係
散布図行列の 1 つのマスに描けるのは、2 つの列の関係だけです。3 つ以上の列が絡む関係、たとえば地域によって面積の効き方が違う交互作用は、面積と価格のマスだけを見ても分かりません。区分の列があれば、hue で色分けした図も描きます。数値の列どうしが絡む関係は散布図行列では確かめられないので、モデルを学習した後に、予測の誤差(残差 (residual))を各列に対して散布図にして確かめます。この図を残差プロットと呼びます。
09 / Exercises
練習問題
例題のデータで価格予測のモデルを作ったときの出力です。散布図行列で何を確かめるかを答えましょう。答えを選ぶと解説が表示されます。
10 / Review
確認問題
答えを選び、解説で理由も確かめましょう。
YOUR PROGRESS
01 / 12
選択肢を1つ選んでください。
Summary
まとめ
列を選ぶ目的変数を最後に置く
図を描くpairplot と、区分での色分け
形を見る曲線・裾・相関・離れた点・一直線・帯
列を直す変換・修正・除外・追加
予測する成約価格を見積もり、誤差で確かめる
- 散布図は 2 つの列の関係を点で表し、向き・強さ・形を読み取ります。相関係数は直線への集まり方を -1 から 1 で表しますが、点の並び方の形は表しません。
- 散布図行列は、数値の列のすべての組の散布図を行列に並べた図です。下の三角が散布図、対角線が各列の分布、上の三角は下の三角の縦横を入れ替えた図です。目的変数を最後に置くと、最下行に目的変数との関係がまとまります。
- 機械学習の前には、曲線・右に長い裾・説明変数どうしの相関・離れた点・目的変数との一直線・色の帯の 6 つの形を確かめ、列ごとに、変換する・直す・外す・加えるを決めます。
- 図で決めた扱いを学習データに反映すると、例題では成約価格の予測の誤差が平均 27.5% から 10.2% に下がりました。最も効いたのは、色分けで見えた地域の違いです。
- 列が多いときは、目的変数の行とヒートマップで列を絞ってから描きます。3 つ以上の列が絡む関係は、色分けや学習後の誤差の図で確かめます。
- 売上・解約・不良率・成約数など、自分の業務の表でも手順は同じです。予測したい数字を目的変数として最後の列に置き、最下行で説明変数との関係を見てから、6 つの形を確かめます。
参考資料
- F. J. Anscombe: Graphs in Statistical Analysis (1973)
- seaborn: seaborn.pairplot
- seaborn: seaborn.PairGrid
- seaborn: seaborn.heatmap
- Microsoft: Excel で Python を使用してプロットとグラフを作成する
- pandas: pandas.plotting.scatter_matrix
- statsmodels: variance_inflation_factor
- scikit-learn: train_test_split
- scikit-learn: Common pitfalls and recommended practices
- 国土交通省: 宅地建物取引業者が受けることができる報酬の額